
Ficha Jev 1.13
Ficha activa del modelo, alias, precio y límites.
El modelo activo es Jev 1.13, con el ID de versión jev-1.13.0. Todos los modelos de la ficha de TypeSafe se sirven mediante POST /v1/systemone; el campo model de la solicitud selecciona qué nombre atiende la llamada. jev-latest es el valor predeterminado del SDK y actualmente se resuelve como jev-1.13.0. jev-preview apunta ahora al mismo ID; TypeSafe indica que no hay ninguna compilación preliminar disponible. Fija el ID de versión si ajustaste umbrales según esta ficha.
Precio, contexto y límites de uso
La entrada cuesta $42 por cada mil millones de tokens, es decir, $0.042 por millón. Los tokens de salida son gratuitos. Una solicitud que supere los límites documentados de 250,000 tokens por segundo o 1,200 solicitudes por minuto devuelve 429 Demasiadas solicitudes. Los SDK oficiales reintentan con espera exponencial y respetan retry-after cuando está presente. TypeSafe advierte que los límites se ajustan dinámicamente mientras la demanda sea alta y se cierren acuerdos de GPU, y que pueden cambiar sin previo aviso. Los planes personalizados y empresariales pueden aumentar el límite mediante sales@typesafe.ai.
El contexto admite 64k tokens por solicitud. Hay un segundo límite de 32k tokens para el estado más la pregunta más larga. Jev procesa el estado una vez y evalúa todas las preguntas en paralelo, por lo que la ventana de 64k abarca el estado y todas las preguntas combinadas. Cuando el estado crece con detalles irrelevantes, la precisión disminuye; ese modo de fallo figura en la página de jaggedness. Agrupa muchas preguntas breves con speculative fan-out en vez de meter todo el almacén de datos en un solo campo.
La entrada solo admite texto: una cadena, un objeto JSON o un arreglo de valores de texto. No admite imágenes, audio ni video. Preprocesa todo contenido no textual y conviértelo en campos antes de realizar la llamada. El inglés es el principal idioma de entrenamiento. Otros idiomas, incluidos los CJK, se procesan con menor precisión, así que mide la confianza antes de automatizar una cola que no esté en inglés.
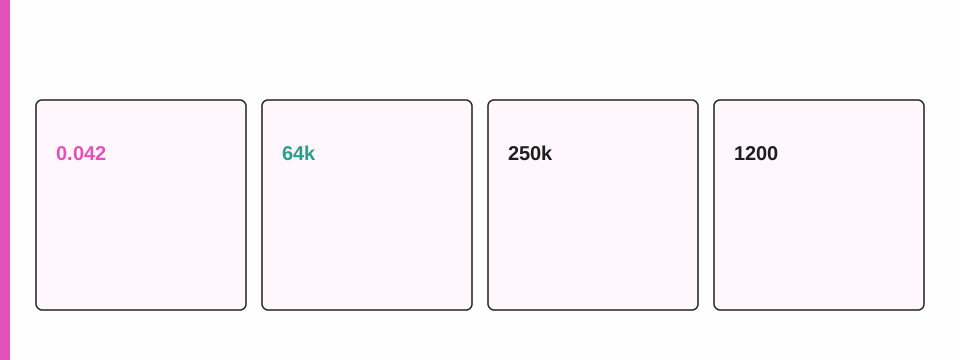
Jev 1.13
- ID del modelo
- jev-1.13.0
- role
- versioned-id
- Precio por millón de tokens de entrada (USD)
- 0.042
- Salida facturada
- false
- tokens por segundo
- 250000
- Solicitudes por minuto
- 1200
- Tokens de contexto
- 64000
- estadoMásTokensDeLaPreguntaMásLarga
- 32000
- input
- text-only
jev-latest
- ID del modelo
- jev-latest
- role
- stable-alias
- apunta a
- jev-1.13.0
- Valor predeterminado del SDK
- true
jev-preview
- ID del modelo
- jev-preview
- role
- preview-alias
- apunta a
- jev-1.13.0
- Compilación preliminar disponible
- false
Alias y listado de modelos
Un alias es un nombre de modelo que se resuelve como un ID de versión. Envíalo en el campo model como cualquier otro nombre. jev-latest designa la versión oficial estable más reciente. jev-preview designa la versión más reciente, sea oficial o no, y se adelanta a jev-latest cuando existe una compilación preliminar. Ahora mismo, ambos nombres apuntan a jev-1.13.0.
Un alias cambia cuando se publica una versión nueva, así que sus respuestas pueden variar sin que modifiques tu código. El campo model de la respuesta informa el ID de versión que respondió. Registra ese ID. Si los umbrales de confianza se ajustaron con jev-1.13.0, sigue enviando jev-1.13.0 hasta que vuelvas a ajustarlos.
GET /v1/models devuelve los nombres que tu cuenta puede enviar, junto con una descripción y la fecha de publicación. Actualmente incluye los alias. Los ID de versión como jev-1.13.0 se aceptan en el campo model aunque no aparezcan en esa lista.
Tratamiento de datos y personalización
Jev no se ajusta de forma específica ni se adapta mediante LoRA con datos de clientes. Tampoco se entrena con solicitudes ni respuestas de clientes. Los mismos pesos de RLCD sirven a todas las cuentas. La especialización se realiza mediante el contenido del estado, las instrucciones, los criterios y la composición en el código. El índice legal de TypeSafe abarca el DPA, la política de privacidad y la retención cero de datos para clientes empresariales.
El tiempo de respuesta integral indicado es 70ms-500ms, con la mayoría de las consultas en torno a 100ms. Ese intervalo es una afirmación publicada en los materiales de lanzamiento, no un objetivo de latencia basado en mediciones propias de esta wiki. Debe leerse junto con la nota sobre límites de frecuencia: el rendimiento y las RPM pueden cambiar mientras TypeSafe amplía el acceso anticipado.
Qué nombre enviar en producción
Envía jev-1.13.0 cuando los umbrales que ajustaste la semana pasada deban conservar el mismo significado la próxima. Envía jev-latest si quieres la versión oficial vigente de TypeSafe y revisarás de nuevo los histogramas de confianza cada vez que cambie el alias. Envía jev-preview solo si estás preparado para una compilación no oficial; hoy apunta al mismo lugar que jev-latest.
Registra response.model en cada llamada. Ese campo contiene el ID de versión que realmente respondió, aunque hayas enviado un alias. Vincúlalo con requestId al depurar un 429 o un Noul inesperado. GET /v1/models no siempre mostrará jev-1.13.0, aunque el endpoint lo acepte.
Calcula solo el costo de entrada. Los tokens de salida son gratuitos, así que fan-out resulta barato frente a un modelo de chat que cobra la generación. Un bucle al estilo de Doom con 10 consultas por segundo a $0.042/MTok es el ejemplo de lanzamiento de esa economía. Aun así, respeta los límites de 1,200 RPM y 250,000 tokens por segundo, y ten en cuenta que esas cifras pueden cambiar sin aviso durante el acceso anticipado.
Cuando ventas cotice un límite personalizado, esa cifra no aparecerá en esta ficha hasta que TypeSafe la publique en docs.typesafe.ai/models. Hasta entonces, las cifras públicas son 250,000 tokens por segundo y 1,200 solicitudes por minuto, con la advertencia explícita de que pueden cambiar sin aviso. La retención cero de datos para empresas corresponde al índice legal, no a un ajuste de la ficha del modelo.
El inglés sigue siendo el idioma con mejor rendimiento en esta ficha. Si atiendes tickets en idiomas CJK, aplica umbrales de confianza más estrictos y toma muestras de tu propia cola antes de prescindir de la intervención humana. El modelo aceptará los caracteres; la nota sobre precisión es un motivo para medir, no un 403 oculto.
El cambio de un alias es un evento de publicación. Vuelve a consultar la página de modelos cuando TypeSafe publique un nuevo ID de versión y decide entonces si tus umbrales siguen siendo válidos. La ficha de esta página corresponde a Jev 1.13, no es una promesa sobre 1.14.
Los tokens de salida siguen siendo gratuitos en esta ficha. Por eso, agrupar preguntas adicionales suele costar menos que una segunda llamada generativa.
Fuentes