
Jev 1.13 模型卡
实时模型卡、别名、价格与限制。
当前在线模型是 Jev 1.13,版本化 ID 为jev-1.13.0。TypeSafe模型卡中的所有模型均通过 POST /v1/systemone 提供服务;请求的 model 字段用于选择处理调用的名称。jev-latest是 SDK 默认值,目前解析为jev-1.13.0。jev-preview目前也指向同一 ID;TypeSafe显示当前没有可用的预览构建。如果你已根据此模型卡调校阈值,请固定使用版本化 ID。
价格、上下文与速率限制
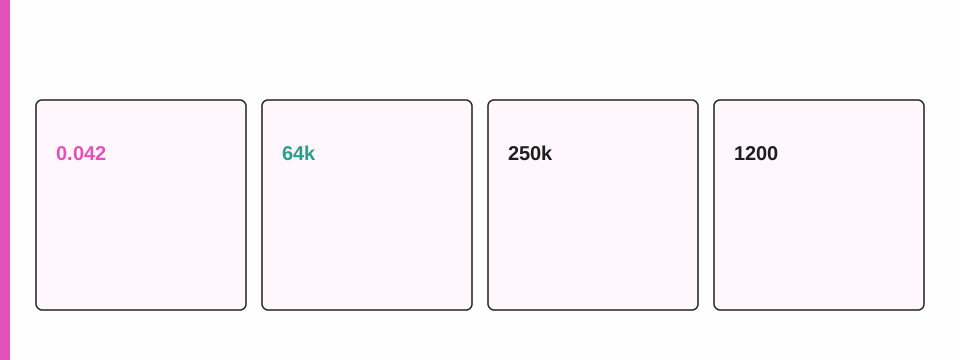
输入价格为每十亿 token $42,即每百万 token $0.042。输出 token 免费。请求超过已公布的每秒 250,000 token 或每分钟 1,200 次请求时,会返回 429 Too Many Requests。官方 SDK 会采用退避机制重试,并在存在 retry-after 时遵循该值。TypeSafe警告称,在需求高涨及 GPU 交易落地期间,限制会动态调整,并可能随时变更且不另行通知。定制和企业方案可通过 sales@typesafe.ai 联系销售提高上限。
每次请求的上下文上限为 64k tokens。另有 32k tokens 的预算,适用于 state 加上最长的问题。Jev 只读取一次 state,随后并行依据它评估所有问题,因此 64k 窗口涵盖 state 与全部问题的总和。随着 state 混入越来越多无关细节,准确率会下降——jaggedness 页面列出了这种失效模式。应通过 speculative fan-out 打包大量短问题,而不是把整个数据仓库塞进一个字段。
仅支持文本输入:字符串、JSON 对象或文本值数组。不支持图像、音频或视频输入。调用前请把非文本内容预处理成字段。主要训练语言是英语。包括中日韩语言在内的其他语言准确率较低,因此在自动处理非英语队列前,请先衡量 Confidence。
Jev 1.13
- 模型 ID
- jev-1.13.0
- role
- versioned-id
- 每百万输入的价格(美元)
- 0.042
- 计费输出
- false
- 每秒词元数
- 250000
- 每分钟请求数
- 1200
- 上下文令牌数
- 64000
- state 加最长问题词元数
- 32000
- input
- text-only
jev-latest
- 模型 ID
- jev-latest
- role
- stable-alias
- 指向
- jev-1.13.0
- SDK 默认值
- true
jev-preview
- 模型 ID
- jev-preview
- role
- preview-alias
- 指向
- jev-1.13.0
- 预览版本可用
- false
别名与模型列表
别名是解析到版本化 ID 的模型名称。像其他名称一样,将其放入 model 字段发送。jev-latest表示最新的官方稳定版本。jev-preview表示最新版本,无论它是否为官方版本;存在预览构建时,它会先于jev-latest更新。目前两个名称都指向jev-1.13.0。
新版本发布时,别名会随之移动,因此即使你的代码未变,其背后的答案也可能改变。响应中的 model 字段会报告实际作答的版本化 ID。请记录该 ID。如果 Confidence 阈值是按jev-1.13.0调校的,在重新调校前请继续发送jev-1.13.0。
GET /v1/models 会返回你的账户可发送的名称,并附带说明和发布日期。目前它会列出别名。即使jev-1.13.0等版本化 ID 未出现在该列表中,也可以在 model 字段中使用。
数据处理与定制
Jev 不会使用客户数据进行微调或 LoRA 适配,也不会基于客户请求或响应进行训练。所有账户使用相同的RLCD权重。你需要通过state内容、指令、标准及代码中的组合方式实现专用化。TypeSafe的法律索引涵盖 DPA、隐私政策,以及企业客户的零数据保留政策。
官方给出的端到端响应时间为 70ms-500ms,多数查询约为 100ms。该范围是发布材料中的公开声明,并非本 wiki 自行测量得出的延迟 SLO。还应结合速率限制说明理解:TypeSafe扩展抢先体验服务期间,吞吐量和 RPM 可能变化。
生产环境该发送哪个名称
如果你希望上周调校的门槛到下周仍保持相同含义,请发送jev-1.13.0。如果你希望使用TypeSafe当前的官方版本,并会在每次别名移动后重新检查 Confidence 直方图,请发送jev-latest。只有在准备好使用非官方构建时才发送jev-preview;目前它与jev-latest指向相同目标。
每次调用都要记录 response.model。即使发送的是别名,该字段也会给出实际作答的版本化 ID。调试 429 或异常Noul时,请将其与 requestId 关联。即使端点接受jev-1.13.0,GET /v1/models 也不一定总会列出它。
只核算输入端费用。输出 tokens 免费,因此与按生成内容收费的聊天模型相比,fan-out 成本很低。以 $0.042/MTok 运行每秒 10 次查询的 Doom 式循环,是发布时用于说明这种成本优势的示例。但仍须遵守 1,200 RPM 和每秒 250,000 tokens 的限制;在抢先体验阶段,这些数值可能随时调整,恕不另行通知。
销售提供的定制限制在TypeSafe将其发布到 docs.typesafe.ai/models 前不会出现在此模型卡上。在此之前,公开数值仍为每秒 250,000 token 和每分钟 1,200 次请求,并明确警告它们可能随时变更且不另行通知。企业零数据保留属于法律索引主题,并非模型卡上的开关。
此模型卡上,英语仍是表现最强的语言。如果你处理 CJK 工单,请使用更严格的 Confidence 门槛,并在移除人工环节前抽样检查自己的队列。模型会接受这些字符;准确率说明意味着你需要实际测量,并不表示存在隐藏的 403。
别名移动属于版本发布事件。当TypeSafe发布新的版本化 ID 时,请重新阅读模型页面,再判断你的门槛是否仍然有效。本页模型卡对应 Jev 1.13,并不承诺 1.14 的情况。
此模型卡仍规定输出 token 免费。因此,多打包几个问题通常比再次调用生成模型更便宜。
来源